
کتاب Natural Language Processing with Spark NLP
کتاب Natural Language Processing with Spark NLP
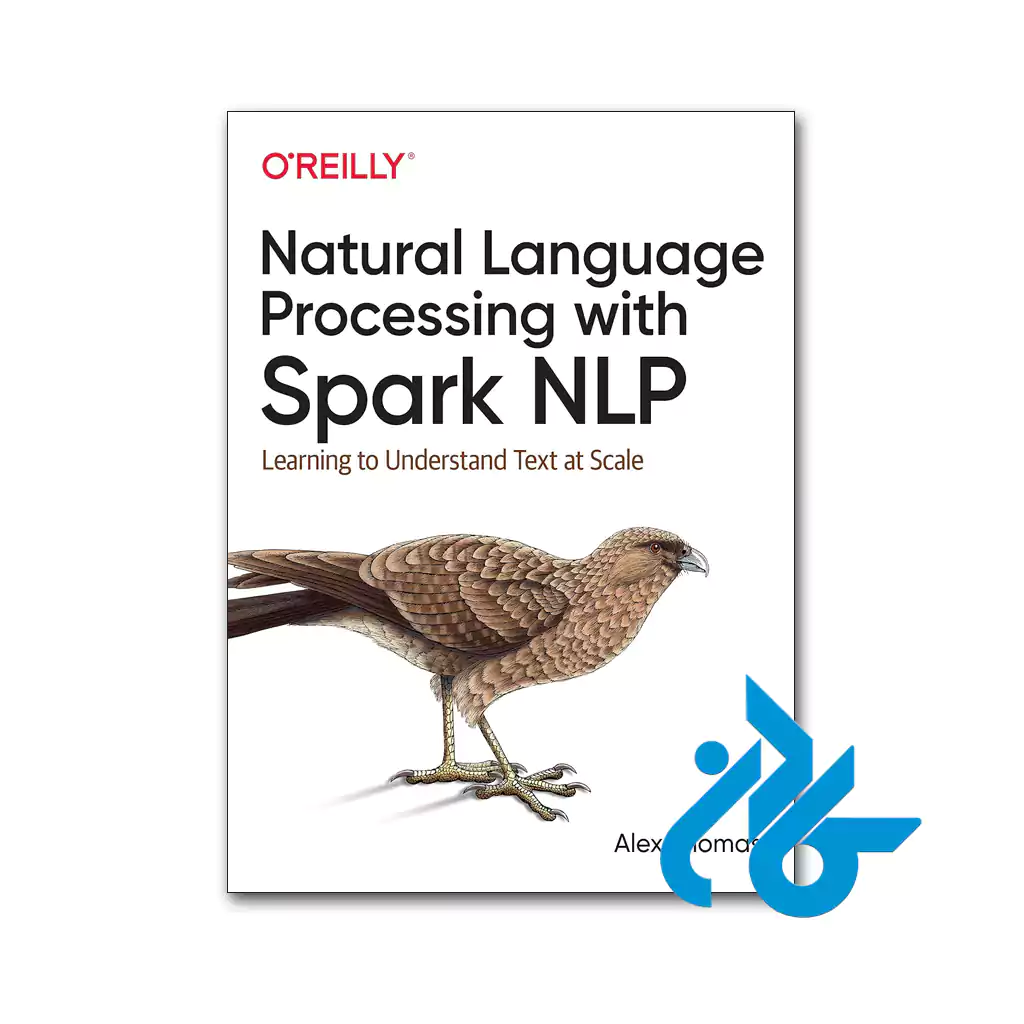
معرفی کتاب Natural Language Processing with Spark NLP:
پردازش زبان طبیعی (Natural Language Processing) یکی از حوزههای مهم هوش مصنوعی و یادگیری ماشین است که هدف آن تحلیل، درک و پردازش زبان انسان توسط سیستمهای کامپیوتری است. با افزایش حجم دادههای متنی در سازمانها، شبکههای اجتماعی، سامانههای پشتیبانی و منابع اطلاعاتی، نیاز به ابزارهایی که بتوانند متن را در مقیاس بالا پردازش کنند، بیشتر شده است.
کتاب Natural Language Processing with Spark NLP با تمرکز بر ترکیب دو فناوری Apache Spark و Spark NLP، به خواننده نشان میدهد چگونه میتوان برنامههای پردازش زبان طبیعی را برای کار با حجم زیادی از داده طراحی و پیادهسازی کرد.
Apache Spark چارچوبی برای پردازش توزیعشده دادههاست و Spark NLP کتابخانهای تخصصی برای پردازش زبان طبیعی بر بستر آن محسوب میشود. ترکیب این دو ابزار امکان ساخت Pipelineهای پردازش متن را فراهم میکند؛ Pipelineهایی که میتوانند مراحل مختلفی مانند پاکسازی متن، Tokenization، استخراج ویژگی، تحلیل و طبقهبندی را بهصورت منظم اجرا کنند.
نویسنده ابتدا خواننده را با مبانی زبان طبیعی، معماری Spark و مفاهیم یادگیری عمیق آشنا میکند و سپس به سراغ تکنیکهای تخصصیتر و ساخت پروژههای کاربردی میرود. در بخشهای پایانی نیز موضوعاتی مانند پشتیبانی از زبانهای مختلف، برچسبگذاری انسانی دادهها و آمادهسازی برنامههای NLP برای محیط Production بررسی میشوند.
ویژگیهای کتاب:
- پردازش متن در مقیاس بزرگ با Apache Spark: یکی از محورهای اصلی کتاب، استفاده از قابلیتهای پردازش موازی و توزیعشده Apache Spark برای کار با دادههای متنی حجیم است. مفاهیمی مانند Spark SQL، Spark MLlib، Transformerها، Estimatorها و Modelها در این مسیر معرفی میشوند.
- آشنایی با مبانی زبانشناسی و NLP: برای ساخت یک سیستم پردازش زبان طبیعی، شناخت ساختار زبان اهمیت زیادی دارد. کتاب مفاهیمی مانند واجشناسی، صرف، نحو، معناشناسی، کاربردشناسی و تفاوتهای زبانی را توضیح میدهد تا خواننده درک بهتری از چالشهای پردازش متن پیدا کند.
- آموزش تکنیکهای اصلی پردازش متن: Tokenization، Stemming، Lemmatization، Normalization، استخراج ویژگی، مدلهای N-Gram و روشهای بازیابی اطلاعات از جمله مباحثی هستند که در بخشهای آموزشی کتاب بررسی میشوند.
- مدلسازی و یادگیری عمیق: کتاب علاوه بر روشهای سنتی پردازش متن، به شبکههای عصبی، مدلهای بازگشتی، LSTM، Word Embeddings و معماریهای Transformer نیز میپردازد. در این بخشها با خانوادههایی از مدلهای زبانی مانند BERT و ELMo آشنا میشوید.
- ساخت برنامههای کاربردی NLP: یکی از نقاط قوت کتاب، تبدیل مباحث فنی به پروژههای واقعی است. تحلیل احساسات، ساخت پایگاه دانش، موتور جستوجو، چتبات و تشخیص متن در تصاویر از جمله کاربردهایی هستند که فرایند طراحی و پیادهسازی آنها بررسی میشود.
- آمادهسازی سیستم برای محیط عملیاتی: کتاب به موضوعاتی مانند بهینهسازی عملکرد Spark، نظارت بر سیستم، مدیریت منابع داده، تست نرمافزار و استقرار مدلها نیز توجه دارد. این بخش برای افرادی که قصد دارند پروژههای آزمایشی را به برنامههای قابل استفاده در سازمان تبدیل کنند، اهمیت ویژهای دارد.
ساختار کتاب Natural Language Processing with Spark NLP:
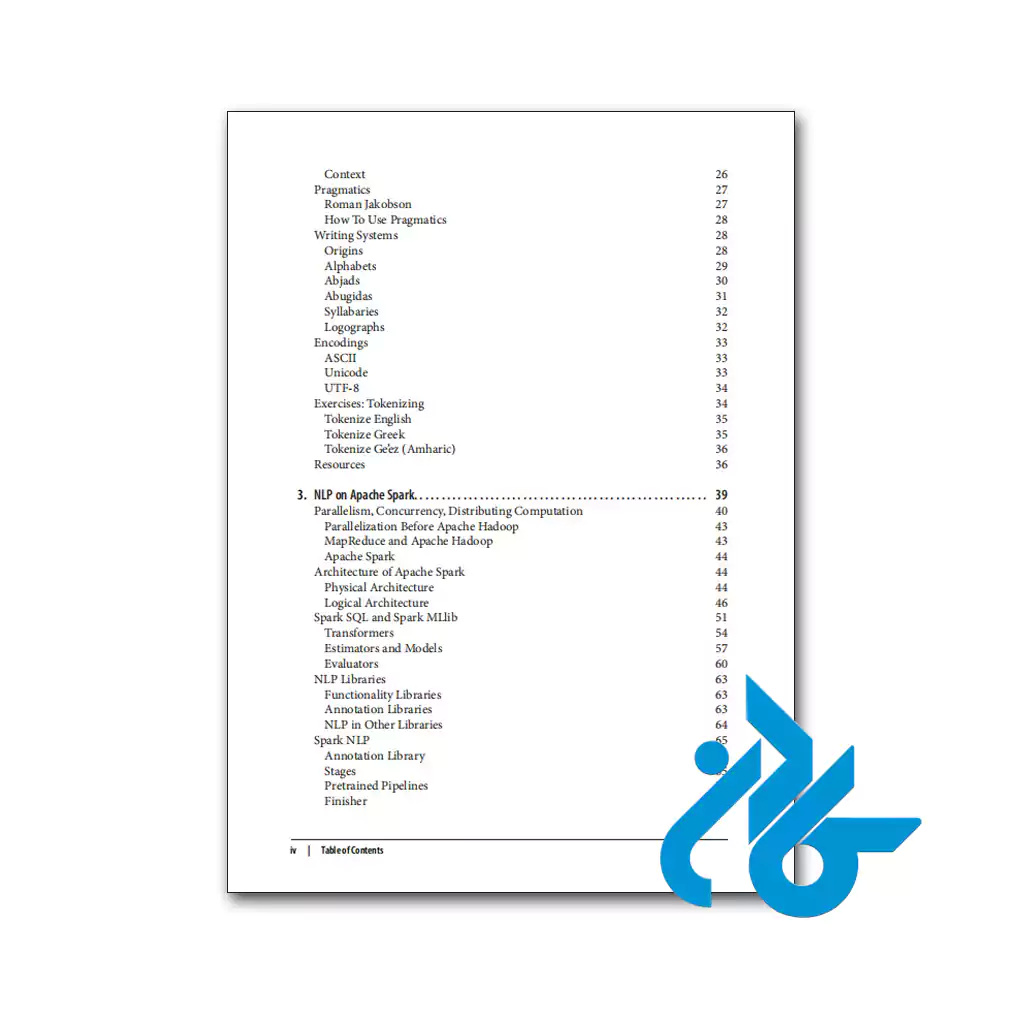
کتاب از 19 فصل در چهار بخش اصلی تشکیل شده است:
- بخش اول: مبانی (Basics)
- فصل 1: Getting Started
- فصل 2: Natural Language Basics
- فصل 3: NLP on Apache Spark
- فصل 4: Deep Learning Basics
- بخش دوم: اجزای سازنده (Building Blocks)
- فصل 5: Processing Words
- فصل 6: Information Retrieval
- فصل 7: Classification and Regression
- فصل 8: Sequence Modeling with Keras
- فصل 9: Information Extraction
- فصل 10: Topic Modeling
- فصل 11: Word Embeddings
- بخش سوم: کاربردها (Applications)
- فصل 12: Sentiment Analysis and Emotion Detection
- فصل 13: Building Knowledge Bases
- فصل 14: Search Engine
- فصل 15: Chatbot
- فصل 16: Object Character Recognition
- بخش چهارم: ساخت سیستمهای NLP (Building NLP Systems)
- فصل 17: Supporting Multiple Languages
- فصل 18: Human Labeling
- فصل 19: Productionizing NLP Applications
کتاب مناسب چه کسانی است؟
کتاب Natural Language Processing with Spark NLP برای گروههای زیر مناسب است:
- مهندسان داده (Data Engineers): برای یادگیری پردازش توزیعشده دادههای متنی و استفاده از Spark در پروژههای NLP.
- دانشمندان داده (Data Scientists): برای توسعه مدلهای طبقهبندی، تحلیل احساسات، استخراج اطلاعات و مدلسازی موضوعی.
- مهندسان یادگیری ماشین: برای طراحی Pipelineهای پردازش زبان طبیعی و آمادهسازی مدلها برای محیط عملیاتی.
- توسعهدهندگان Python و Apache Spark: برای گسترش مهارتهای برنامهنویسی در حوزه تحلیل و پردازش متن.
- پژوهشگران هوش مصنوعی: برای آشنایی با روشهای کلاسیک و یادگیری عمیق در NLP.
- دانشجویان علوم کامپیوتر و داده: برای آشنایی با ارتباط میان زبانشناسی، یادگیری ماشین و مهندسی نرمافزار.
سطح کتاب:
مقدماتی تا متوسط (Beginner to Intermediate)
طبق دستهبندی رسمی O’Reilly، این کتاب در سطح مقدماتی تا متوسط قرار دارد. با این حال، برای استفاده مؤثر از تمرینها و بخشهای پیادهسازی، آشنایی اولیه با برنامهنویسی، ترجیحاً Python، مفاهیم پایه یادگیری ماشین و کار با دادهها مفید است.
آشنایی با Apache Spark و پردازش توزیعشده پیشنیاز قطعی برای شروع کتاب نیست، اما تجربه قبلی در این زمینه به درک سریعتر بخشهای فنی کمک میکند.
قیمت و خرید کتاب Natural Language Processing with Spark NLP از فروشگاه کادن:
اگر قصد دارید پردازش زبان طبیعی را از مبانی تا ساخت برنامههای کاربردی یاد بگیرید و با نحوه استفاده از Apache Spark در پروژههای دادهمحور آشنا شوید، این کتاب میتواند منبعی کاربردی برای توسعه مهارتهای شما باشد.
شما می توانید کتاب Natural Language Processing with Spark NLP: Learning to Understand Text at Scale را از فروشگاه همواره تخفیف کادن با کیفیت بسیار عالی و قیمت مناسب تهیه کنید و از مطالعه ی آن لذت ببرید.
| زبان | انگلیسی |
|---|---|
| نویسنده | الکس توماس (Alex Thomas) |
| ناشر | انتشارات اریلی میدیا (O’Reilly Media) |
| قطع کتاب | وزیری |
| نوع کاغذ | تحریر |
| نوع جلد | جلد نرم (شومیز) |
| نوع چاپ | سیاه سفید کیفیت عالی A (دیجیتال) |
| تعداد صفحه | 364 |
| وزن | 610 گرم |
| شابک (ISBN) | 978-1492047728 |
برای فرستادن دیدگاه، باید وارد شده باشید.
محصولات مرتبط


نقد و بررسیها
پاکسازی فیلترهنوز بررسیای ثبت نشده است.