
- ارسال 24 ساعته در تهران
- ارسال به شهرستان در 2 تا 4 روز کاری
- بسته بندی ایمن
- گارانتی بازگشت کالا
- پشتبیانی 7 روز و 24 ساعته
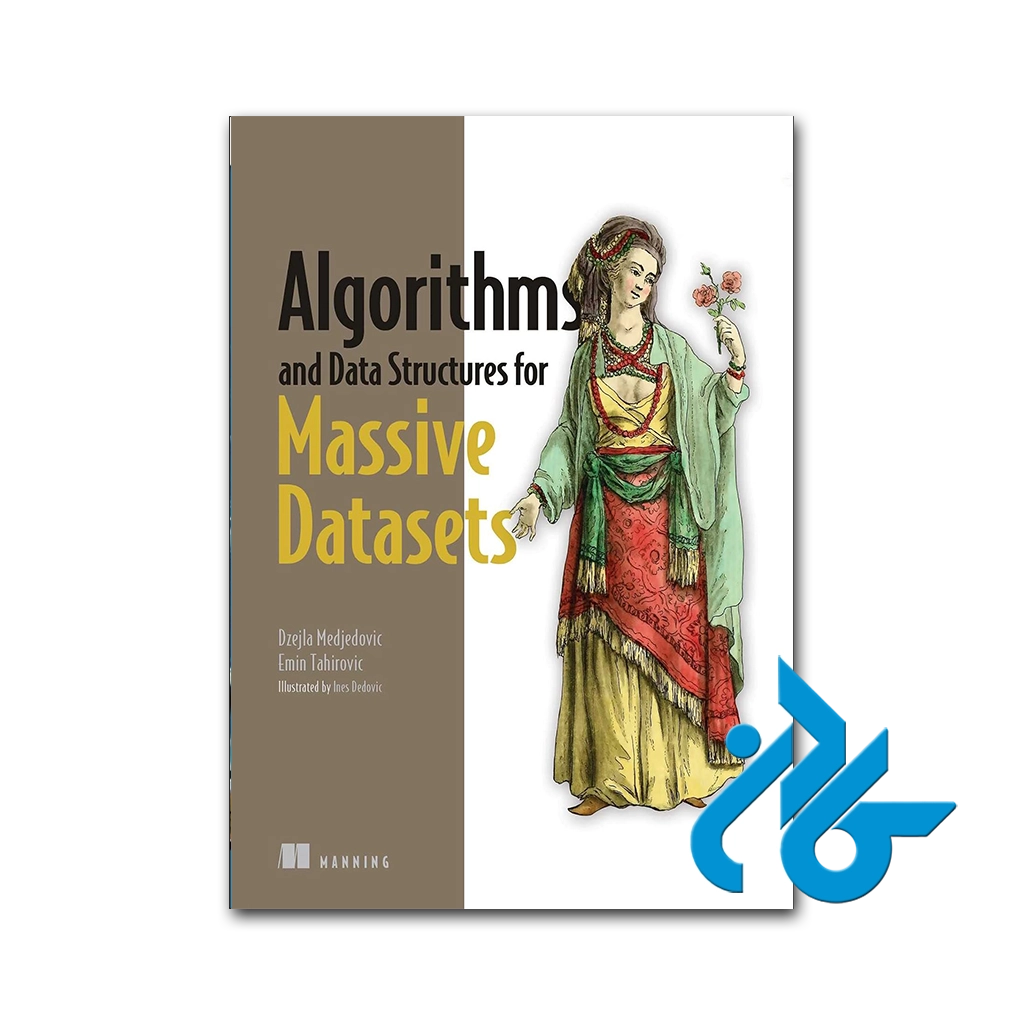
کتاب Algorithms and Data Structures for Massive Datasets
توضیح کوتاه در رابطه با محتوای کتاب:
اگه با دادههای حجیم سروکار داری یا دوست داری وارد دنیای مهندسی داده و سیستمهای مقیاسپذیر بشی، این کتاب میتونه انتخاب خیلی خوبی برات باشه. با مطالعه اون یاد میگیری چطور بدون مصرف بیرویه حافظه و منابع پردازشی، حجم زیادی از اطلاعات رو مدیریت و تحلیل کنی. آشنایی با ابزارهایی مثل Bloom Filter، HyperLogLog و LSM-Tree هم دید فنی قویتری نسبت به سیستمهای مدرن دادهمحور بهت میده. اگر میخوای دانش الگوریتمی خودت رو از سطح مباحث دانشگاهی به کاربردهای واقعی صنعت برسونی، پیشنهاد میکنم این کتاب رو از دست ندی.
اطلاعات کتاب:
| زبان | انگلیسی |
|---|---|
| نویسنده | امین طاهروویچ (Emin Tahirovic), ژیلا مدیدوویچ (Dzejla Medjedovic) |
| ناشر | انتشارات منینگ (Manning Publications) |
| قطع کتاب | وزیری |
| نوع کاغذ | تحریر |
| نوع جلد | جلد نرم (شومیز) |
| نوع چاپ | سیاه سفید کیفیت عالی A (دیجیتال) |
| تعداد صفحه | 304 |
| وزن | 510 گرم |
| شابک (ISBN) | 978-1617298035 |
2,800,000 تومان قیمت اصلی 2,800,000 تومان بود.1,400,000 تومانقیمت فعلی 1,400,000 تومان است.
توضیحات سیمی کردن کتاب ها
با توجه به اینکه تمامی کتابها دارای جلد و بهصورت سلفونشده عرضه میشوند، خدمات سیمیکردن بهطور پیشفرض بدون طلق انجام خواهد شد.
هزینه درجشده در بخش «سیمیکردن» نیز مربوط به سیمیکردن بدون طلق است.
چنانچه تمایل دارید برای کتاب شما طلق نیز اضافه شود، لطفاً این درخواست را در قسمت یادداشت سفارش ثبت کنید. پس از ثبت سفارش، کارشناسان پشتیبانی کادن برای هماهنگی هزینه و جزئیات با شما تماس خواهند گرفت.
فرق چاپ دیجیتال با افست چیست؟
چاپ دیجیتال بیشتر برای تیراژ پایین و چاپ سریع بهکار میرود. در این روش، فایل مستقیماً از کامپیوتر روی دستگاه چاپ منتقل میشود و برای چاپ چند جلد کتاب یا نمونه اولیه بسیار مناسب است.
اما چاپ افست برای تیراژ بالا استفاده میشود و کیفیت رنگ و جزئیات در آن بسیار بالاتر است. در چاپ افست ابتدا زینک تهیه میشود و سپس طرح روی کاغذ منتقل میگردد. این روش برای چاپهای حرفهای و اقتصادی در تعداد زیاد کاربرد دارد.
تفاوت قطع وزیری و رحلی و رقعی در کتاب چیست؟
قطع وزیری یکی از رایجترین اندازههای کتاب است و ابعادی حدود ۲۴ در ۱۷ سانتیمتر دارد. این نوع قطع برای کتابهای درسی، دانشگاهی و آموزشی بسیار پرکاربرد است.
اما قطع رحلی بزرگتر بوده و معمولاً اندازه آن ۲۹ در ۲۱ سانتیمتر یا حتی بیشتر است. این قطع برای کتابهای تصویری، زبان، فرهنگ لغت و کتابهای آموزشی با جزئیات زیاد استفاده میشود تا خوانایی و فضای صفحه بیشتر باشد.
قطع رقعی یکی از رایجترین قطعهای کتاب در بازار نشر ایران است و ابعادی حدود ۲۱ در ۱۴ سانتیمتر دارد. این قطع بیشتر برای رمانها، کتابهای داستانی، مذهبی و آثار عمومی استفاده میشود، زیرا خوشدست بوده و برای مطالعه طولانیمدت بسیار مناسب است.
تفاوت جلد سخت و جلد نرم چیست؟
کتاب با جلد سخت (Hardcover) دارای رویهای محکم از جنس مقوای ضخیم یا گالینگور است که با روکش سلفون یا پارچه پوشانده میشود. این نوع جلد دوام بسیار بالایی دارد و برای کتابهای نفیس، مرجع یا هدیهای انتخاب میشود.
در مقابل، جلد نرم (Paperback) از مقوای نازکتر ساخته شده و سبکتر و اقتصادیتر است. بیشتر کتابهای آموزشی و رمانها با جلد نرم چاپ میشوند.
تفاوت کاغذ تحریر، بالک و گلاسه چیست؟
کاغذ تحریر (Wood-free Paper)
کاغذ تحریر متداولترین نوع در چاپ کتاب است. رنگی سفید و سطحی مات دارد که باعث میشود چشم هنگام مطالعه خسته نشود.
این نوع کاغذ برای کتابهای درسی، دانشگاهی، آموزشی و رمانها بسیار مناسب است.
ویژگیها:
- رنگ سفید و طبیعی
- ضخامت و استحکام مناسب
- جذب خوب جوهر چاپ
- مناسب برای نوشتن و یادداشتبرداری
کاغذ بالک (Book Paper / Bulky Paper)
کاغذ بالک کمی ضخیمتر و سبکتر از کاغذ تحریر است و معمولاً رنگ آن کرم یا نخودی است.
در نتیجه هنگام مطالعه، نور کمتری منعکس میشود و چشم کمتر خسته میشود. به همین دلیل در کتابهای حجیم مثل رمانهای طولانی یا منابع آموزشی پرصفحه، بسیار محبوب است.
ویژگیها:
- رنگ گرم (کرم یا نخودی)
- سبکتر از تحریر
- حس طبیعیتر هنگام ورق زدن
- مناسب برای مطالعه طولانیمدت
کاغذ گلاسه
کاغذ گلاسه سطحی براق و صاف دارد که رنگها را بسیار زنده و درخشان نمایش میدهد.
این نوع کاغذ بیشتر برای کتابهای تصویری، کاتالوگها، مجلات رنگی و کتابهای آموزشی تصویردار استفاده میشود.
ویژگیها:
- سطح براق و صاف
- نمایش شفاف رنگها
- وزن نسبتاً بالا
- مناسب برای چاپ تصاویر باکیفیت
- ارسال 24 ساعته در تهران
- ارسال به شهرستان در 2 تا 4 روز کاری
- بسته بندی ایمن
- گارانتی بازگشت کالا
- پشتبیانی 7 روز و 24 ساعته
کتاب Algorithms and Data Structures for Massive Datasets
معرفی “کتاب algorithms and data structures for massive datasets ”
کتاب Algorithms and Data Structures for Massive Datasets نوشته دژلا مدجوویچ (Dzejla Medjedovic) و امین طاهرویچ (Emin Tahirovic)، اثری تخصصی و کاربردی در زمینه طراحی الگوریتمها و ساختارهای داده برای پردازش مجموعهدادههای بسیار بزرگ است. نویسندگان با رویکردی عملی توضیح میدهند که چرا الگوریتمهای سنتی در مواجهه با حجم عظیم اطلاعات و سیستمهای توزیعشده با محدودیتهای عملکردی روبهرو میشوند.
موضوعاتی مانند جدولهای درهمسازی، فیلترهای Bloom، الگوریتم Count-Min Sketch، ساختار HyperLogLog، پردازش دادههای جریانی (Data Streams) و درختهای LSM در این کتاب بررسی میشوند. همچنین مباحثی مانند نمونهگیری از دادهها، محاسبه صدکها، مرتبسازی دادههای حجیم و طراحی ساختارهای ذخیرهسازی کارآمد مورد توجه قرار گرفتهاند. تمرکز اصلی اثر بر معرفی روشهایی است که امکان پردازش سریعتر دادهها، کاهش مصرف حافظه و حفظ دقت قابلقبول در سیستمهای مقیاسپذیر را فراهم میکنند.
کتاب الگوریتمها و ساختارهای داده برای مجموعه دادههای حجیم برای چه کسانی مناسب است؟
کتاب Algorithms and Data Structures for Massive Datasets برای مهندسان داده، دانشمندان داده، توسعهدهندگان نرمافزار، متخصصان پایگاه داده و دانشجویان رشتههای علوم کامپیوتر و مهندسی نرمافزار مناسب است. افرادی که با سیستمهای پردازش دادههای بزرگ، معماریهای توزیعشده، تحلیل دادههای جریانی و طراحی زیرساختهای مقیاسپذیر سروکار دارند، میتوانند از مطالب آن استفاده کنند.
همچنین برنامهنویسانی که قصد دارند دانش خود را درباره الگوریتمهای پیشرفته و ساختارهای داده به سطح کاربردهای صنعتی ارتقا دهند، مخاطبان اصلی این اثر هستند. آشنایی مقدماتی با الگوریتمها، ساختمان داده و برنامهنویسی میتواند در درک بهتر مباحث تخصصی کتاب مؤثر باشد. مثالهای ارائهشده با زبانهای Python و R و همچنین شبهکد، امکان استفاده از مطالب را برای طیف متنوعی از متخصصان فراهم میکند.
مقایسه کتاب الگوریتمز اند دیتا استراکچرز فور مسیو دیتاستس با آثار مرتبط:
در مقایسه با کتاب Mining of Massive Datasets نوشته جوری لسرسون، ریجوانی و مایکل ماهونی، این اثر تمرکز بیشتری بر ساختارهای داده و الگوریتمهای عملی برای مدیریت محدودیت حافظه و پردازش دادههای حجیم دارد. کتاب Mining of Massive Datasets بیشتر به الگوریتمهای استخراج الگو، تحلیل شبکهها و یادگیری از دادههای بزرگ میپردازد، در حالی که کتاب Algorithms and Data Structures for Massive Datasets موضوعاتی مانند Bloom Filters، HyperLogLog، Count-Min Sketch و LSM-Trees را با تأکید بر کاربردهای مهندسی بررسی میکند.
همچنین در مقایسه با Designing Data-Intensive Applications نوشته مارتین کلپمن، که دیدگاهی گسترده درباره معماری سیستمهای دادهمحور ارائه میدهد، کتاب حاضر وارد جزئیات فنیتری از الگوریتمها و ساختارهای داده مورد استفاده در این سیستمها میشود. بنابراین، این اثر میتواند مکمل مناسبی برای منابع تخصصی مهندسی داده و طراحی سیستمهای مقیاسپذیر باشد.
نتیجه گیری:
مهمترین مزیت کتاب Algorithms and Data Structures for Massive Datasets، تبدیل مفاهیم پیشرفته الگوریتمی به راهکارهایی قابلاستفاده در پروژههای واقعی دادهمحور است. بررسی روشهای احتمالاتی برای تخمین تعداد عناصر، تشخیص دادههای تکراری، محاسبه فراوانی اطلاعات و تحلیل دادههای جریانی، به خواننده کمک میکند با محدودیتهای حافظه و پردازش در مقیاس بزرگ آشنا شود.
همچنین مقایسه ساختارهایی مانند B-Trees، Bε-Trees و LSM-Trees، درک بهتری از نحوه انتخاب راهکار مناسب برای پایگاههای داده ایجاد میکند. استفاده از مثالهای صنعتی، تمرینهای کاربردی و توضیحات تصویری نیز یادگیری مفاهیم پیچیده را سادهتر میسازد. در مجموع، این کتاب منبعی ارزشمند برای توسعه مهارتهای فنی در حوزه کلانداده، مهندسی داده و طراحی الگوریتمهای مقیاسپذیر محسوب میشود.
خرید و قیمت کتاب ALGORITHMS AND DATA STRUCTURES FOR MASSIVE DATASETS از فروشگاه کادن
- هماکنون میتوانید این کتاب را با قیمت مناسب و ارسال سریع از فروشگاه اینترنتی کادن تهیه کنید.
- زبان انگلیسی و چاپ با کیفیت
- ارسال به سراسر کشور
- ضمانت اصالت کالا
| زبان | انگلیسی |
|---|---|
| نویسنده | امین طاهروویچ (Emin Tahirovic), ژیلا مدیدوویچ (Dzejla Medjedovic) |
| ناشر | انتشارات منینگ (Manning Publications) |
| قطع کتاب | وزیری |
| نوع کاغذ | تحریر |
| نوع جلد | جلد نرم (شومیز) |
| نوع چاپ | سیاه سفید کیفیت عالی A (دیجیتال) |
| تعداد صفحه | 304 |
| وزن | 510 گرم |
| شابک (ISBN) | 978-1617298035 |


نقد و بررسیها
پاکسازی فیلترهنوز بررسیای ثبت نشده است.